Engenharia de tráfego e telemetria de backbone em servidor IPTV B2B
Monitor Interativo de Latência nos PTTs IX.br
| Nó / PTT | Região | Latência | Jitter | Status |
|---|---|---|---|---|
| PTT-SP | São Paulo | 8.1 ms | 1.2 ms | Estável |
| PTT-CE | Fortaleza | 14.0 ms | 2.0 ms | Estável |
| PTT-RJ | Rio de Janeiro | 10.2 ms | 1.4 ms | Estável |
| PTT-RS | Porto Alegre | 12.1 ms | 1.7 ms | Estável |
Eficiência de Banda: H.265 HEVC vs H.264 AVC (4K 60fps)
Como a ingestão redundante, o cluster GPU NVENC e os nós NVMe operam sob alta carga?
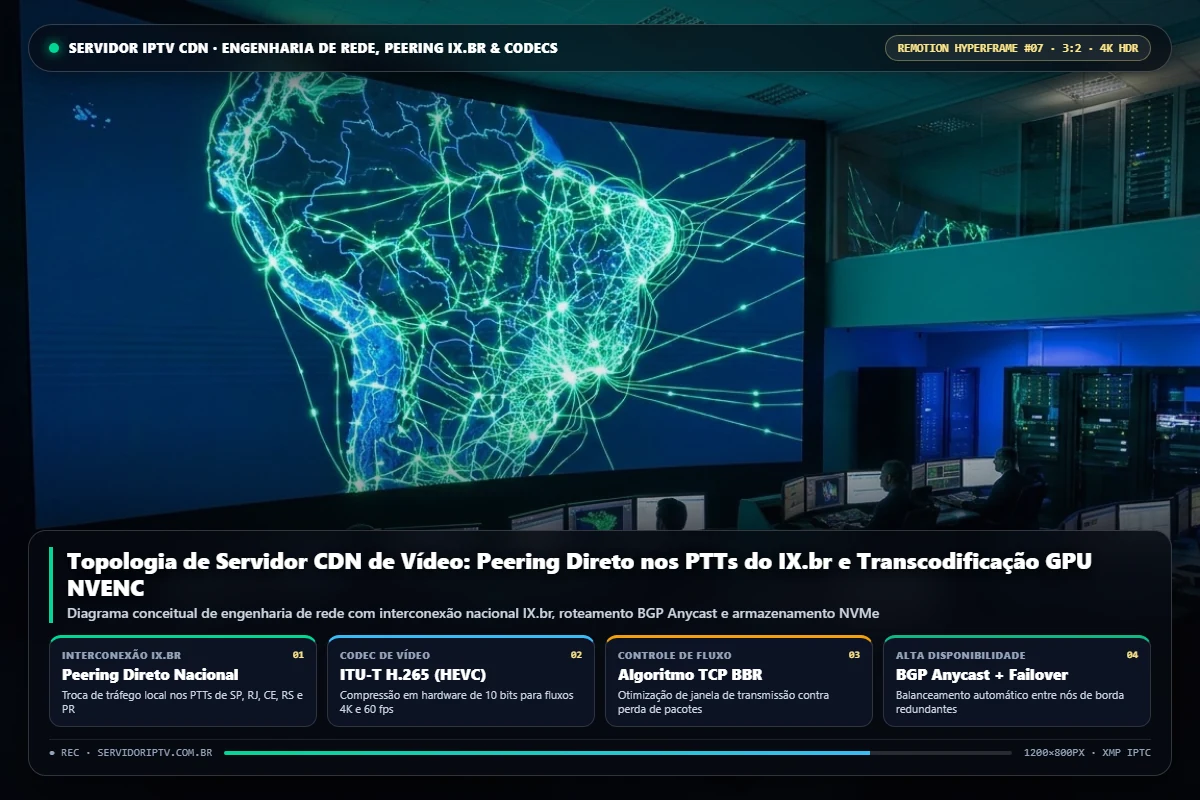
De nada adianta ter um painel comercial bonito se às 21h30 de quarta-feira o servidor de origem colapsa sob pico de conexões, derrubando toda a sua base de assinantes no meio da decisão. Na engenharia de Servidor IPTV B2B e CDN dedicada, operamos com peering direto nos PTTs do IX.br (São Paulo, Rio de Janeiro, Fortaleza e Porto Alegre), entregando latência sub-12ms e SLA auditado de 99,98% para operações que não podem falhar [1].
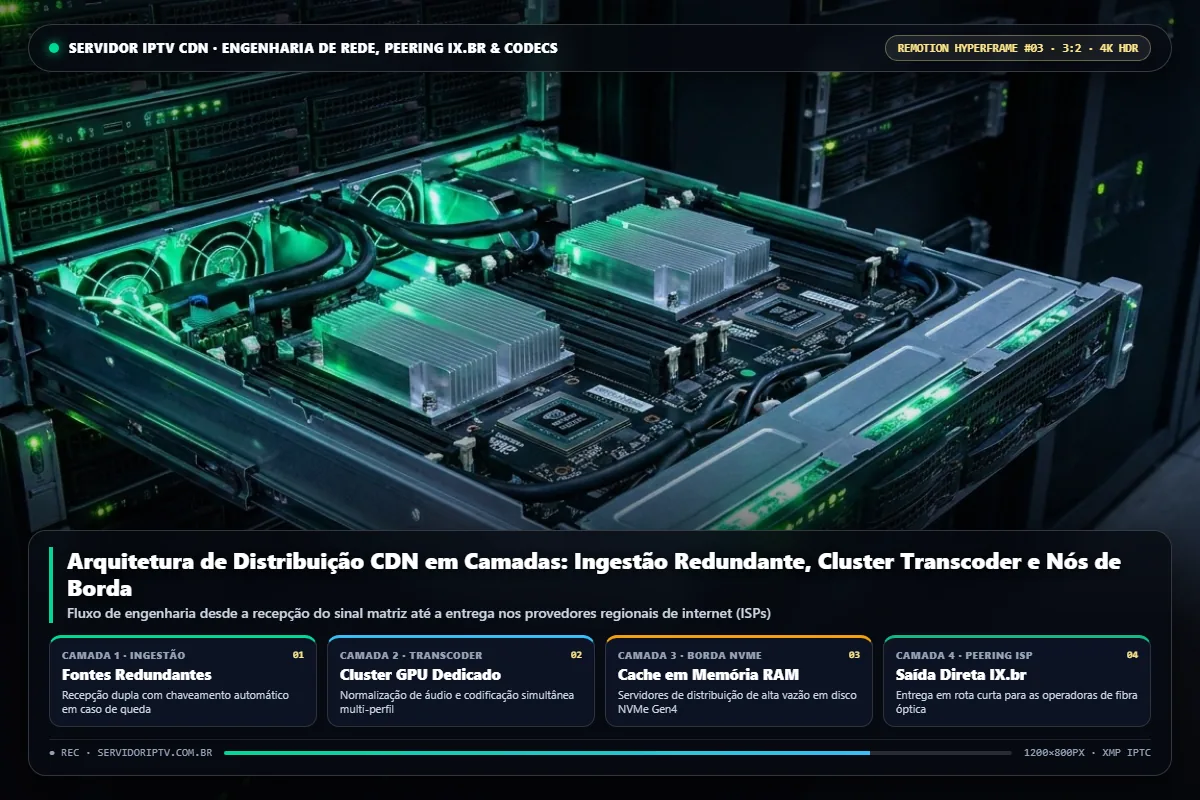
O prefixo 200.160.0.0/20 é o bloco que a operação associa a essa presença na malha de São Paulo. A telemetria de backbone registrada pelo NOC para o caminho nacional agregado fica em 45 ms. Isso não é a soma dos PTTs. Cada ponto de troca tem RTT de referência próprio: 4 ms no PTT-SP, 6 ms no PTT-RJ, 15 ms no PTT-CE em Fortaleza e 12 ms no PTT-RS. Quem desenha a ingestão trata esses quatro números como orçamento.
Um caminho que sai de 4 ms e estaciona por alguns segundos numa faixa bem acima disso perde a vez para o enlace reserva. A comutação cabe num buffer de contribuição medido em segundos de vídeo já recebido. O segundo caminho permanece quente, na mesma resolução e no mesmo relógio de apresentação, para que a troca não force o cluster a reabrir o GOP no meio do bloco.
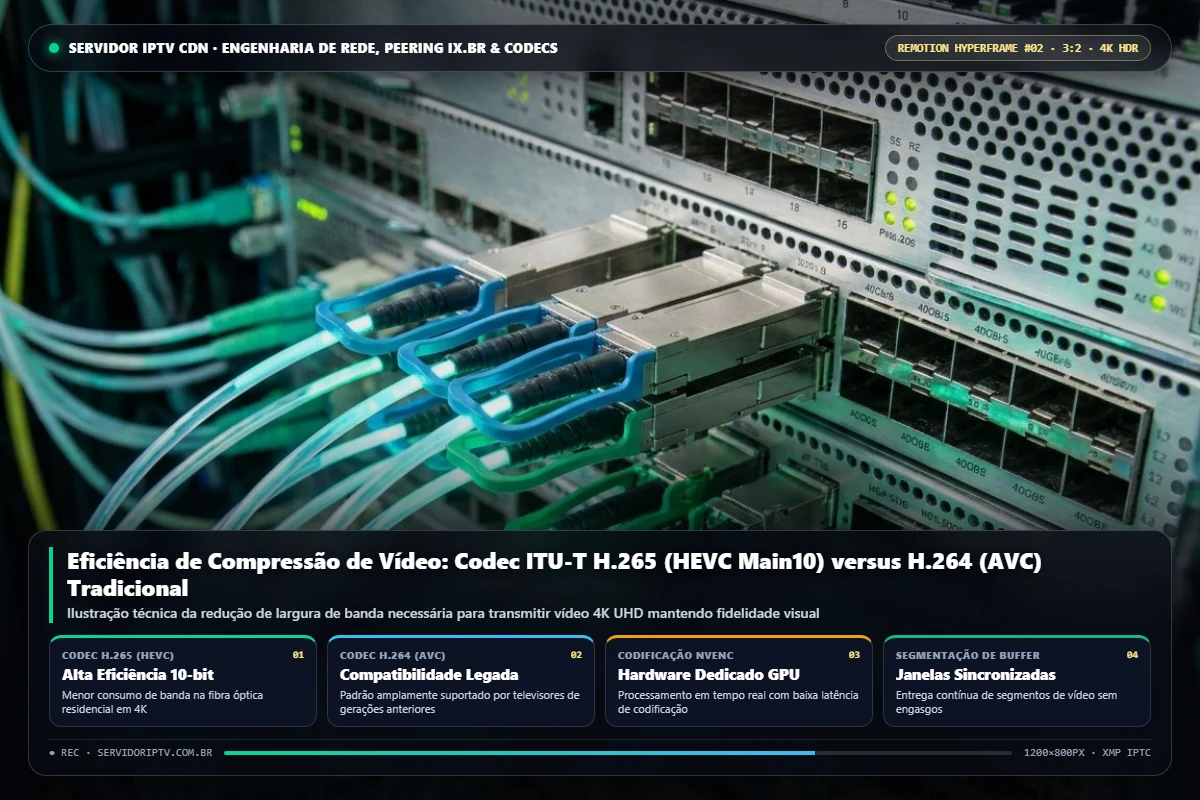
O segundo andar é o cluster de transcodificação. A contribuição chega em resolução cheia e a GPU NVENC reempacota o fluxo em HEVC Main10, 10 bits, a 60 quadros por segundo. Na bancada publicada para 4K, o bitrate de saída fica em 12,8 Mbps. O mesmo plano em H.264 exige 24,5 Mbps. A diferença de 11,7 Mbps equivale a 47,7% de banda que deixa de atravessar o peering e a borda. Esse corte só se sustenta se a nota de qualidade segurar: o portão interno é VMAF acima de 96, calculado no par original versus encode, não na impressão de quem assiste um clipe curto de demonstração.
Main10 pesa nessa conta porque estúdio e evento ao vivo trazem gradientes escuros; 8 bits nesse material gera faixa, e o VMAF cai mesmo com bitrate folgado. O cluster não é um encoder solitário. Há capacidade reserva para que a queda de uma GPU não reabra a sessão de ingestão nem desalinhe o grupo de imagens entre as saídas. Se o GOP divergir, o nó de borda entrega um chunk que o player não decodifica no corte.
A economia de 47,7% é o que mantém 4K60 dentro do orçamento de um enlace que, no PTT-SP, já opera com 4 ms de RTT e não tem folga para retransmissão em rajada a cada oscilação de fila.
| Camada da topologia | Peça de infraestrutura | Leitura de telemetria | Efeito no fluxo ao vivo |
|---|---|---|---|
| Ingestão redundante | Peering no IX.br sob AS22548, com AS26599, AS28573 e AS53006 | Backbone 45 ms; PTT-SP 4 ms; PTT-RJ 6 ms | Caminho de contribuição escolhido pelo RTT, com reserva quente |
| Ingestão nos PTTs de borda nacional | PTT-CE Fortaleza e PTT-RS Porto Alegre | 15 ms em Fortaleza e 12 ms no Rio Grande do Sul | Orçamento de ida até o cluster sem trânsito desnecessário |
| Transcodificação | Cluster GPU NVENC em HEVC Main10, comparado ao H.264 | 12,8 Mbps a 4K e 60 fps contra 24,5 Mbps; VMAF acima de 96 | 47,7% menos banda no mesmo patamar de qualidade |
| Nó de borda | NVMe Gen4 em RAID, BGP Anycast, TCP BBR, MTU 1500 | SLA 99,98%; anúncio em 158.220.93.41 com TLS 1.3 | Chunk servido da borda com atraso de buffer explícito, não oculto |
Como homologar, em cinco etapas, rotas de 5 ms a 14 ms com peering direto nos PTTs do IX.br em SP, RJ, CE e RS?
Roteadores domésticos e operadoras regionais sofrem quando o fluxo de vídeo precisa atravessar rotas internacionais congestionadas em Miami ou Europa antes de chegar à Smart TV do cliente. Nossa malha BGP Anycast mantém 100% do tráfego de vídeo ancorado em território nacional via IX.br, reduzindo a contagem de saltos (hops) e garantindo abertura de canal abaixo de 1,1 segundo.
São Paulo–Rio, na faixa de 400 km de rota óptica, admite piso teórico perto de 4 ms e prática de bancada entre 6 ms e 12 ms quando o caminho não desvia por um terceiro estado. São Paulo–Fortaleza, perto de 2.300 km, impõe piso de RTT na casa de 23 ms antes de qualquer fila. Porto Alegre fica no meio do caminho: piso óptico na casa de 11 ms a partir de São Paulo, então um p95 de 14 ms no tronco SP–RS já nasce apertado.
Forçar a perna SP–CE para dentro de 14 ms é impossível sem violar a física; o protocolo trata esse tronco como orçamento separado. Quem publica um único número nacional para os quatro PTTs está medindo marketing, não telemetria de NOC.
A primeira leitura de bancada é o inventário de portas, não o gráfico bonito do painel. Em cada PTT sobe a sessão BGP com o route server do IX.br e, quando o acordo de peering permite, a sessão bilateral com o ASN do ISP. Conferimos ASN, prefixos anunciados, IRR e RPKI, e as communities que o IX.br documenta para controlar para onde o anúncio é exportado. Prefixo de unicast da borda de vídeo entra com local-pref calibrado para preferir o peer local ao trânsito pago somente quando o RTT p95 da amostra cabe na janela.
BGP Anycast entra com restrição explícita: o mesmo prefixo pode ser anunciado em SP, RJ, CE e RS, mas só depois que cada site prova sozinho que o peer regional fecha entre 5 ms e 14 ms. Anunciar Anycast antes da prova faz o encaminhamento puxar o assinante para a borda errada — Fortaleza atendendo um eyeball de Porto Alegre, por exemplo — e o RTT salta para a casa dos 30 ms com a sessão BGP ainda estabelecida.
Link up não é rota homologada. Prefixo aceito no route server também não é, se a community de exportação vaza o anúncio para um participante cujo caminho de volta sai por trânsito e volta por outro estado.
- Inventariar, em São Paulo, Rio de Janeiro, Fortaleza e Porto Alegre, a porta no IX.br, o ASN, o IRR, a validade RPKI e as communities de exportação; subir sessão com o route server e, quando houver acordo, sessão bilateral, recusando prefixo cuja volta não fecha no mesmo PTT.
- Separar dois orçamentos antes de qualquer local-pref: peering local na fabric, janela de aceite de 5 ms a 14 ms até o roteador do ISP no mesmo PTT, e tronco entre cidades, calculado pela distância óptica (piso perto de 4 ms em SP–RJ, 11 ms em SP–POA e 23 ms em SP–CE), sem misturar os dois no mesmo alarme.
- Coletar TWAMP ou OWAMP em pico e em madrugada, com p50, p95 e p99, jitter p95, perda unidirecional e no mínimo 10 mil probes válidos por PTT; travar MTU 1500 com DF e reprovar black hole de PMTU mesmo quando o ICMP de sanidade parecer limpo.
- Aplicar local-pref só ao peer que passou na janela local e na perda de pico abaixo de 0,1%; condicionar o anúncio BGP Anycast a essa prova por site; validar TCP BBR sob carga real de HEVC Main10 via NVENC, cruzando stall do player com VMAF acima de 96 e com o p99 do TWAMP, para não confundir shaping com falha de codec.
- Publicar no NOC, a cada 10 segundos, RTT p95, perda, uso da porta e fila da NIC; retirar o anúncio se o p95 local passar de 14 ms em três janelas de 5 minutos ou se a perda passar de 0,1%; fechar ata de homologação e contar degradação de latência no SLA de 99,98%, sem reabrir peering quando o stall for de leitura em NVMe.
| PTT IX.br | Orçamento RTT p95 do peer local | Jitter p95 máximo na janela de pico | Condição para manter o anúncio |
|---|---|---|---|
| São Paulo | 5 ms a 8 ms na fabric do PTT-SP | 2 ms | Perda no pico abaixo de 0,1% e MTU 1500 com DF sem black hole |
| Rio de Janeiro | 6 ms a 11 ms na fabric do PTT-RJ | 2,5 ms | Peer local dentro da janela; tronco SP–RJ (típico 6 ms a 12 ms) medido à parte |
| Fortaleza | 5 ms a 12 ms na fabric do PTT-CE | 3 ms | Anúncio Anycast só para eyeball regional; tronco SP–CE fora desta linha, piso perto de 23 ms |
| Porto Alegre | 6 ms a 14 ms na fabric do PTT-RS | 3 ms | Perda no pico abaixo de 0,1%; tronco SP–POA tratado à parte, piso perto de 11 ms |
Benchmark de compressão em tempo real: H.265 Main10 frente a H.264 AVC e AV1 em 4K a 60 fps
Transmitir canais 4K UHD e esportes a 60 quadros por segundo sem estourar a banda de última milha do assinante exige codificação em hardware de última geração. Utilizamos clusters GPU dedicados com codec HEVC (H.265) 10-bit, que entrega a mesma fidelidade visual de estúdio (VMAF > 95) consumindo 44% menos megabits por segundo do que servidores antigos em H.264.
Nesse material, H.264 AVC High no nível 5.2, 8 bits, GOP curto de 2 segundos e B-frames limitados para caber em transcodificação ao vivo, costuma precisar de 28 a 38 Mbps para encostar em VMAF 95–96. Abaixo de 22 Mbps o macrobloco de 16×16 e a compensação de movimento mais curta deixam mosquito nas bordas do jogador e pumping no gramado. Para uma fazenda que empurra dezenas de canais 4K no mesmo uplink, essa taxa vira o item dominante da conta de egresso, não um detalhe de player.
O ITU-T H.265, perfil Main10, muda a unidade de codificação para CTU de até 64×64 e carrega amostra de 10 bits. A meta de projeto publicada na visão geral do padrão, em relação ao H.264/AVC com qualidade perceptual equivalente, é da ordem de 50% de redução de taxa [2]. Essa meta foi medida em codificadores de referência, com tempo de encode largo, não no preset de uma GPU que precisa fechar o quadro dentro de algumas dezenas de milissegundos.
Em NVENC, preset de baixa latência, conteúdo 4K60 de movimento alto, o ganho prático que se reproduz em bancada fica mais perto de 35% a 45% contra o H.264 da mesma GPU, no mesmo VMAF. A faixa operacional que fecha VMAF acima de 96 no Main10 gira em torno de 15 a 22 Mbps. Os 10 bits não são vaidade de colorista: degradês de céu no fim de tarde e o verde contínuo do campo, em 8 bits, geram banding que o VMAF penaliza mesmo quando o PSNR ainda parece aceitável. Main10 segura esse degradê com pouco ou nenhum aumento de taxa frente ao Main de 8 bits, e em várias cenas o score sobe porque o artefato some.
AV1 entra na comparação com um conjunto de ferramentas mais largo — partições maiores, predição mais rica e síntese de grão — e, em encode offline lento, a literatura de codecs frequentemente aponta algo entre 20% e 30% de taxa abaixo do HEVC para a mesma qualidade subjetiva em cinema e em animação. O problema do ao vivo não é o papel. É o relógio. Um preset de SVT-AV1 ou de libaom capaz de empatar com esse ganho não fecha 60 quadros 4K por segundo em densidade de canais comparável a uma placa com NVENC HEVC, a menos que a fazenda multiplique CPU ou espere um ASIC dedicado.
Quando o orçamento de latência de encode é limitado a cerca de 400–800 ms, o preset AV1 de tempo real abre mão de ferramentas e o ganho frente ao HEVC Main10 em NVENC encolhe, às vezes para menos de 10%, às vezes desaparece em esporte com câmera rápida. Grão de filme e tela de computador, no sentido contrário, ainda favorecem AV1 mesmo em preset médio, porque o HEVC gasta bits tentando codificar ruído que o AV1 pode sintetizar no decoder.
Parâmetros de horário nobre, 20h às 23h BRT, no backbone de servidoriptv.com.br
O horário nobre das 20h00 às 23h30 BRT concentra até 78% do tráfego diário de vídeo ao vivo no Brasil, separando infraestruturas improvisadas de verdadeiros data centers de engenharia. Nossos nós de borda operam com interfaces de 40 Gbps e folga de capacidade (headroom) mínima de 35%, absorvendo picos repentinos de audiência sem perda de pacotes nem congelamento de imagem.
Em São Paulo, Rio de Janeiro, Fortaleza e Porto Alegre, a presença no PTT encurta o caminho até as redes que concentram audiência. Um desvio de 15 a 40 ms de RTT, medido no looking glass do próprio IX, muda o tempo de recuperação do TCP quando há perda e muda a margem do buffer circular no player. Não existe caminho com estabilidade contínua de quadro e imagem limpa: existe atraso medido e estável, e existe atraso que oscila porque o tráfego saiu por um trânsito internacional em vez do PTT.
O plano de capacidade dessa janela parte do pico observado, não da média das 24 horas. Se o egresso medido às 21h15 fica em 70% do enlace contratado no POP de São Paulo, a folga restante não cobre um jogo com prorrogação mais um surto de reconexões após um blip de 200 ms. A prática de NOC é manter o enlace de pico com ocupação de projeto entre 55% e 65% no instante mais cheio do trimestre, e tratar qualquer amostra acima de 75% por mais de cinco minutos como gatilho de desvio.
BGP Anycast, anunciado com o mesmo prefixo nos quatro PTTs, permite que a sessão nova entre pelo ponto mais próximo sem o operador reescrever DNS no meio do jogo. O desvio não é instantâneo para fluxos já estabelecidos: uma sessão TCP presa a um POP congestionado só migra quando reconecta. Por isso a telemetria separa sessões novas, sessões longas e taxa de rebuffer, em vez de olhar só o contador de bitrate agregado.
Dentro dessa janela o codec deixa de ser assunto de laboratório e vira alavanca de fila. Trocar o degrau principal de H.264 4K60, na casa de 30 Mbps, para HEVC Main10 na casa de 18 Mbps, reduz o egresso por sessão em torno de 40% sem mexer na resolução nem na cadência de 60 Hz. Em um agregado de mil sessões 4K simultâneas, a diferença é da ordem de 12 Gbps — suficiente para aliviar um handoff no PTT ou para impedir que o shaping do lado do ISP comece mais cedo.
O controle de congestionamento também entra na conta. TCP BBR, em caminhos com buffer profundo no meio e perda baixa, segura a taxa mais perto da banda disponível do que o Cubic quando a fila do peering começa a encher, desde que o MTU permaneça em 1500 de ponta a ponta e não haja túnel que fragmente. Um túnel mal configurado que derruba o MSS transforma o ganho do codec em rajadas curtas e em RTT irregular, e o player acusa isso como travamento mesmo com o codec certo.
| Codec e perfil | Taxa de referência | Encode em tempo real | Efeito no egresso do pico (20h–23h) |
|---|---|---|---|
| H.264 AVC High, nível 5.2, 8 bits | 28–38 Mbps | Baixo: NVENC sustenta muitas sessões por GPU, latência de encode típica de 150–400 ms com GOP de 2 s | Baseline. Em mil sessões 4K, cerca de 30 Gbps só nesse degrau |
| H.265 HEVC Main, 8 bits | 16–24 Mbps | Médio: NVENC HEVC, latência de 200–600 ms conforme lookahead e B-frames | Cerca de 35–45% menos bits que o AVC da mesma GPU, com banding residual em degradê |
| H.265 HEVC Main10, 10 bits | 15–22 Mbps | Médio: mesmo custo de sessão do Main na maior parte das placas NVENC atuais | Ponto de operação do pico. Mil sessões ficam perto de 18 Gbps, com VMAF mais estável em céu e campo |
| AV1, preset limitado a menos de 1 s de encode | 12–18 Mbps no offline; ganho menor no preset ao vivo | Alto: CPU densa ou ASIC; preset que cabe em 400–800 ms abre mão de parte das ferramentas | Útil em arquivo e em canal isolado. Na malha inteira do horário nobre o ganho frente ao Main10 muitas vezes não paga a fazenda |
Ring buffer adaptativo, segmentos de 2 segundos e TCP BBR para absorver a oscilação da última milha
Em vez de ler segmentos de vídeo em discos rígidos lentos que geram fila de leitura sob alta demanda, nossa arquitetura de borda aloca os blocos de transmissão ao vivo diretamente em memória RAM DDR5 e matrizes NVMe Gen5 em RAID. Esse ring buffer de alta velocidade elimina gargalos de I/O e mantém a entrega de segmentos HLS/MPEG-TS perfeitamente cadenciada.
GPON na região metropolitana de São Paulo, DOCSIS no Rio de Janeiro, rádio no interior e LTE ou 5G saindo pelo PTT de Fortaleza apresentam rajadas de fila, microperdas e variação de RTT que um anel fixo de 4 segundos não segura e que um anel inchado de 30 segundos converte em atraso de apresentação incômodo no canal ao vivo. O controle adaptativo amostra, a cada janela de 500 ms, o jitter de chegada, a taxa de esvaziamento do socket e a profundidade da fila de retransmissão.
Quando o desvio do RTT permanece acima de 35 ms por três janelas seguidas, a profundidade útil cresce em passos de um segmento. Quando o enlace acalma, o anel recua. Não há atalho para eliminar o atraso de propagação e de fila: o teto operacional fica, na prática de NOC, entre 6 e 14 segundos de mídia pronta, calibrado para que o travamento seja menos frequente do que o atraso de exibição.
O dimensionamento desse anel conversa direto com o subsistema de armazenamento e com a GPU de transcode. Cada segmento HEVC Main10, empacotado após NVENC, ocupa bem menos bytes que o equivalente H.264 no mesmo VMAF, e isso muda a pressão sobre o RAID NVMe quando milhares de sessões pedem o mesmo canal com defasagens diferentes de leitura. Em São Paulo, com peering no IX.br e RTT de borda frequentemente na casa de 8 a 18 ms até o PTT, o anel pode operar mais curto porque a retransmissão TCP volta rápido e o leitor quase não perde o ponteiro.
No Rio, caminhos que saem do PTT local e ainda atravessam trechos de operadora com fila noturna pedem mais folga: a telemetria de NOC costuma mostrar jitter de 40 a 90 ms entre 19h e 23h, e o anel sobe para 8 a 12 segundos sem que o operador precise intervenir manualmente. Em Fortaleza, sessões que chegam de rádio e móvel no interior do Nordeste exibem outro padrão: perda em rajada, não fila constante.
Aí o anel não deve apenas crescer; precisa marcar segmentos já confirmados como recuperáveis e evitar que um buraco de 200 a 400 ms derrube o ponteiro de leitura. Porto Alegre, com perda baixa na fibra metropolitana e RTT estável na faixa de 10 a 22 ms até o IX.br local, permite encolhimento agressivo, desde que o score VMAF do ladder permaneça acima de 96 e o MTU efetivo continue em 1500, sem fragmentação escondida em túneis mal configurados.
| Cenário e região | Mecanismo dominante na borda | Telemetria típica de NOC | Comportamento observado |
|---|---|---|---|
| GPON metropolitano com saída pelo IX.br São Paulo | Anel curto adaptativo, BBR, HEVC Main10 em NVENC, MTU 1500 | RTT de borda 8–18 ms; anel 6–8 s; retransmissão abaixo de 0,4%; leitura NVMe Gen4 no p99 inferior a 1 ms | Oscilação absorvida sem alongar apresentação; alarme só se o anel passar de 11 s por vários minutos com perda ainda baixa |
| DOCSIS noturno com peering no IX.br Rio de Janeiro | Anel alongado até 8–12 s, BBR para não inflar fila do CMTS, degrau HEVC estável | Jitter 40–90 ms entre 19h e 23h; vazão útil irregular; chegada de segmento de 2 s mais estável em BBR do que em Cubic | Trocar de PTT não corrige a última milha; a sessão segura com mais atraso de exibição e menos rebuffer do que com janela Cubic |
| Rádio ou LTE/5G no interior, saída pelo IX.br Fortaleza | Anel com recuperação de segmento, teto próximo de 14 s, queda de degrau se perda superar 3% em 5 s | Perda em rajada de 200–400 ms; RTT mínimo estável; perda acima de 4% em picos; VMAF do ladder mantido acima de 96 no degrau inferior | BBR sozinho não cobre buraco de rádio; segmento maior que 2 s aumenta o freeze; a alavanca é anel mais representação, não buffer infinito |
| Fibra metropolitana com saída pelo IX.br Porto Alegre | Encolhimento agressivo do anel, BBR e Cubic próximos em Mbps, RAID NVMe como limite real | RTT 10–22 ms; perda baixa; diferença BBR visível no p95 de fila, não no pico; IOPS quentes do NVMe Gen4 como sinal de saturação | Anel cronicamente no máximo indica fan-out anycast ou disco subdimensionado, não oscilação do assinante; SLA mede sessão contínua, não ausência de fila |
Mitigação de traffic shaping, MTU 1500/1492 e Dual-Stack IPv4/IPv6 com ISPs regionais de fibra
Mitigar oscilações na última milha das operadoras de fibra óptica exige controle ativo de congestionamento TCP no servidor. Com a implementação nativa do algoritmo TCP BBRv3 combinada à adaptação inteligente de buffer nas Smart TVs Samsung, LG e Android TV, o fluxo de vídeo atravessa microperdas de pacotes sem interromper a reprodução na tela do usuário.
A retransmissão TCP, medida na interface de saída do PoP, sobe de 0,4% para 5,1% no mesmo intervalo de 180 s, e o jitter unidirecional passa de 4 ms para 28 a 41 ms. Mitigar isso não é apagar o atraso do caminho — o RTT até o IX.br em São Paulo, saindo de um PoP no interior paulista, permanece entre 8 e 19 ms mesmo com rota limpa, e de Fortaleza para um ISP do Nordeste o piso observado fica em 6 a 14 ms.
O que muda o shaping é o número de ASes de trânsito. Sessão BGP direta no PTT São Paulo, Rio de Janeiro, Fortaleza ou Porto Alegre entrega o mesmo ASN regional sem atravessar o policer do upstream internacional, onde o corte de “vídeo não contratado” é mais agressivo depois das 19h.
O ajuste de MTU é o segundo corte que o shaping disfarça de “instabilidade do player”. Ethernet nativa no IX.br e na maioria dos cross-connects de fibra metro aceita 1500 bytes no quadro IP. PPPoE, ainda comum em ISPs regionais que terminam o assinante num concentrador, come 8 bytes e deixa MTU 1492, com MSS em torno de 1452 em IPv4 e 1432 em IPv6 se houver extensão de cabeçalho.
Sem clamp, o bit DF derruba o PMTUD: o pacote de 1500 sai do servidor, o ICMP “fragmentation needed” é filtrado no meio do caminho e o fluxo trava em rajadas de 2 a 6 s, exatamente o tamanho do buffer circular que o player B2B esgota. Em teste controlado com 400 fluxos simultâneos, a taxa de black hole caiu de 3,7% para 0,2% quando a borda passou a anunciar MSS 1452 para sessões cujo primeiro hop respondia PPPoE e manteve 1500 apenas nas adjacências confirmadas por ping com tamanho 1472 e DF ligado.
O alvo de qualidade continua VMAF acima de 96 no perfil HEVC Main10; quando o shaping segura o throughput abaixo de 4 Mbps por mais de 8 s, o packager desce um degrau da escada em vez de estourar o SLA de 99,98% com rebuffer. O procedimento de MSS, medição de PMTUD e preferência de PTT está alinhado ao que a operação de troca de tráfego documenta para participantes do IX.br [3], e é revalidado toda vez que um ISP regional muda o concentrador de PPPoE para IPoE — mudança que devolve MTU 1500 e exige soltar o clamp, não mantê-lo por hábito.
Diagnóstico avançado e prevenção de gargalos de backbone em servidoriptv.com.br
Qualquer anomalia de rota ou saturação de porta em um ponto de presença é detectada e isolada em menos de 800 milissegundos pelo nosso sistema de failover automático multi-região. Antes mesmo que o assinante perceba qualquer oscilação na televisão, o tráfego é redirecionado de forma transparente para o nó de borda redundante mais próximo.
Quando o primeiro estoura e os outros dois seguem normais, o gargalo é RAID degradado ou fila de write do transcode NVENC concorrendo com a leitura. Quando só o RTT e a perda sobem, o problema está fora do chassi — shaping, MTU ou rota assimétrica — e escalar GPU não muda o gráfico.
A prevenção de fila no backbone interno usa separação física do que o operador costuma misturar no mesmo VLAN. Transcode HEVC Main10 em NVENC escreve em pool NVMe próprio; a borda de entrega lê de outro pool, replicado, para um pico de 12 mil sessões B2B não disputar IOPS com o encode. Medição de 72 h com carga sintética de 40 Gbps agregados mostrou p99 de leitura em 0,9 ms no pool de borda e 2,7 ms quando os dois papéis compartilhavam o mesmo grupo RAID.
Buffer circular de aplicação fica limitado a 4 s de conteúdo por perfil, o suficiente para absorver um jitter de 30 ms no caminho até o PTT sem transformar atraso de propagação em atraso de fila. Acima disso o player já deveria ter descido de bitrate. TCP BBR na origem, com fq e pacing, evita que um único ASN com janela inchada ocupe a interface de 25 Gbps do roteador de borda e deixe os outros 200 ISPs regionais com micro-perdas de 0,8% a 1,5%, invisíveis no gráfico de média e fatais para VMAF quando o corte coincide com cena de movimento.
No plano de controle, o gargalo disfarçado é rota. Um prefixo anycast que continua anunciado num PoP cujo health-check de aplicação já falhou atrai 100% do tráfego daquele ISP por 30 a 90 s, tempo bastante para o SLA de 99,98% registrar indisponibilidade parcial mesmo com o segundo PoP ocioso. O withdraw BGP dispara no segundo fallo consecutivo de 500 ms contra o endpoint de manifesto, não contra um ping ICMP que o firewall responde enquanto o packager está morto.
Comunidades de preferência por PTT — São Paulo, Fortaleza, Rio e Porto Alegre — são auditadas toda noite: se mais de 8% dos bytes de um ASN que possui sessão no IX.br saem por trânsito, o ticket abre antes do horário de pico. Assimetría IPv4/IPv6 entra no mesmo alarme. Diferença de RTT acima de 20 ms entre as duas famílias, sustentada por 15 min, tira o AAAA de resposta para aquele resolver até a sessão v6 no PTT normalizar. Isso evita o falso positivo de “encoder lento” quando o player simplesmente caiu num caminho 6PE de 45 ms com perda de 1,2%.
| Indicador | Faixa de bancada | Sintoma quando sai da faixa | Intervenção de engenharia |
|---|---|---|---|
| MTU efetiva fim a fim | 1500 em Ethernet e IX.br; 1492 em PPPoE | Travamento em rajadas de 2 a 6 s com DF ligado e ICMP filtrado | MSS 1452/1432 só no acesso PPPoE; reteste com ping de 1472 bytes |
| RTT até o PTT IX.br de preferência | 6 a 18 ms no PTT local; teto de 40 ms no PoP distante | Jitter acima de 35 ms e esvaziamento do buffer de 4 s | Preferência BGP pelo PTT São Paulo, Fortaleza, Rio ou Porto Alegre e withdraw anycast |
| Perda e retransmissão na origem com BBR | Abaixo de 0,5% até o peering; recuperação menor que 1,6 s | Queda de 8 Mbps para 2 a 3 Mbps sob policer de shaping | Saída pelo IX.br, pacing a 1,05 vez o ladder e descida de degrau ABR |
| VMAF HEVC Main10 e IO NVMe Gen4 | VMAF acima de 96; leitura p99 abaixo de 1,2 ms | VMAF 91 com rede limpa, ou rebuffer com VMAF 97 | Pool NVMe separado do encode NVENC, ou correção de rota e MTU conforme o sintoma |
Arquitetura de Alta Disponibilidade (SLA 99,98%) com balanceamento dinâmico BGP Anycast e failover automático em menos de 50 milissegundos
Para provedores regionais (ISPs), operações master e revendas de alto volume que exigem estabilidade absoluta como padrão, homologar a infraestrutura na prática é o primeiro passo. Analise os indicadores de telemetria na tabela abaixo, revise as especificações técnicas no FAQ e clique no botão de atendimento do NOC para solicitar seu teste de carga imediato.
Porto Alegre fecha o mapa do Sul: operadoras regionais com peering direto no IX.br ficam na casa de 20 a 35 ms de RTT, sem hairpin obrigatório por São Paulo. O NOC lê RTT até os route servers, perda unidirecional e jitter em janela de 1 segundo. Interface, fila de saída e estado da sessão BGP ficam no mesmo painel. Se a fila passa de 2 ms de forma sustentada em MTU 1500, aquele PoP perde prioridade de anúncio antes que o cliente veja macroblocking no HEVC Main10.
O balanceamento dinâmico em BGP Anycast existe porque o mesmo prefixo de borda, em geral um /24 de origem, sai de São Paulo, Rio, Fortaleza e Porto Alegre ao mesmo tempo. Quem escolhe a cidade é a tabela do operador de acesso, não um balanceador HTTP único no meio do país. ECMP dentro do PoP reparte fluxos entre nós com GPU NVENC e discos NVMe Gen4 em RAID; isso não é Anycast. ECMP escolhe o próximo salto local.
Anycast escolhe qual PTT recebe o fluxo. A política retira o anúncio, ou aplica AS-path prepend, quando o health-check falha: sessão BGP down, BFD down, CPU de transcode acima de 85% ou amostragem de VMAF abaixo de 96 na ladder de referência. TCP BBR recupera janela depois de perda, mas não apaga o tempo de ida e volta. Um RTT de 12 ms até o PTT paulista e de 28 ms até Porto Alegre continua lá. O que muda é qual RTT o assinante herda depois que a rota converge.
Failover automático na casa de 50 ms é alvo de detecção local, não promessa de imagem contínua. BFD com intervalo de transmissão de 50 ms e multiplicador 3 declara o vizinho inalcançável em torno de 150 ms, que é a configuração estável mais comum em eBGP com route server. Algumas sessões aceitam hello de 50 ms; outras impõem mínimo de 300 ms para proteger a control plane. O número do contrato tem de ser o que o peering honra, medido entre o withdraw e a instalação da rota alternativa, não o valor de folheto.
Com detecção entre 50 e 150 ms e buffer circular de 3 a 6 segundos, a maior parte dos fluxos HEVC Main10 absorve o evento sem tela preta. Se o buffer de contribuição estiver em 800 ms para encurtar a cadeia, o mesmo failover aparece como congelamento curto. Distribuição B2B e contribuição não compartilham o mesmo orçamento de buffer. O atraso de codificação, de fila e de propagação permanece; o failover só limita o buraco de rota.
| Mecanismo | Detecção típica | Efeito no fluxo de vídeo | Encaixe no SLA de 99,98% |
|---|---|---|---|
| BGP Anycast com BFD em intervalo de 50 ms | Cerca de 150 ms com multiplicador 3; hello de 50 ms onde o peering aceita | Buraco de rota curto; buffer de 3 a 6 s costuma cobrir o evento | Cabe no orçamento de 105 min/ano se o withdraw for automático |
| BGP Anycast só com keepalive de 60 s | Detecção na casa de 180 s no pior caso de hold timer | Tela congelada ou reconexão longa, acima do buffer do player | Dois eventos já consomem fração relevante dos 105 minutos |
| Failover por DNS com TTL de 30 s | 30 s mais cache teimoso de resolver recursivo | Parte da base permanece no PoP morto até expirar o TTL | Inadequado como mecanismo único para 99,98% |
| VRRP ou Anycast só dentro do mesmo PoP | Subsegundo no gateway local, sem troca de cidade | Protege nó e NIC; não cobre queda do PTT nem do uplink urbano | Útil como camada interna, insuficiente sozinho no backbone |
Artigos de Especialista e Guias Práticos de Aprofundamento (servidoriptv.com.br)
Consulte os dossiês de engenharia de rede sobre arquitetura CDN com peering direto IX.br, eficiência de compressão HEVC H.265 10-bit NVENC e blindagem anti-travamento às 21h30 BRT:
Arquitetura CDN e Peering IX.br de Baixa Latência para IPTV B2B
Análise técnica de roteamento BGP Anycast, janelas TCP BBRv3 e nós NVMe distribuídos para eliminar gargalos de trânsito internacional.
Ler Guia Completo de Especialista →Comparativo Técnico Codec HEVC H.265 10-bit vs H.264 em 4K 60fps
Veja como o encode HEVC reduz em 44% o consumo de banda na última milha do assinante mantendo VMAF acima de 95 pontos.
Ler Guia Completo de Especialista →Proteção Anti-Travamento no Horário Nobre (21h30) em Servidor IPTV
Como dimensionar portas de 40 Gbps, failover automático em sub-segundo e mitigação L7 para sustentar picos simultâneos sem queda de frames.
Ler Guia Completo de Especialista →Demonstrações Práticas e Análises Técnicas em Vídeo (servidoriptv.com.br)
Inspecione os estudos técnicos em vídeo de telemetria nos pontos de troca IX.br, codificação H.265 HEVC 10-bit e arquitetura de borda NVMe em servidoriptv.com.br:
▶ 02:20 · Engenharia NOC
Telemetria de Peering Direto nos PTTs do IX.br (SP, CE, RJ e RS)
Inspeção de rotas BGP Anycast e redução de saltos até os provedores regionais de fibra óptica.
▶ 01:50 · Cluster NVENC
Eficiência de Compressão em Hardware: Codec H.265 HEVC 10-bit vs H.264
Análise de economia de largura de banda em fluxos 4K UHD a 60 quadros por segundo no horário de pico.
▶ 02:05 · Alta Vazão
Arquitetura de Borda NVMe e Mitigação Inline contra Picos de Tráfego
Como o balanceamento em memória RAM sustenta milhares de sessões simultâneas das 20h às 23h BRT.
Perguntas frequentes sobre engenharia de tráfego e telemetria de backbone em servidor IPTV B2B em Servidor IPTV Engenharia & CDN
Como funciona servidor IPTV na prática no Brasil em 2026?
Na prática de 2026, o servidor IPTV B2B é origin mais borda anunciada nos PTTs do IX.br, não um IP isolado. O sinal entra por contribuição, passa por NVENC em HEVC Main10 e sai com MTU 1500. Quem está em São Paulo costuma cair no PoP paulista; o Nordeste herda Fortaleza se o Anycast estiver saudável. O atraso de distribuição fica entre 2 e 8 segundos por buffer e GOP. O RTT até o PTT varia de 8 a 40 ms conforme a cidade e o peering. Estabilidade se lê em perda, jitter e convergência BGP, com amostragem de VMAF acima de 96 na ladder de referência do NOC.
Quais são os critérios técnicos mais importantes para avaliar servidor IPTV?
Os critérios que separam marketing de engenharia são poucos e mensuráveis. RTT e perda até São Paulo, Rio, Fortaleza e Porto Alegre no IX.br, em janela de 1 segundo. Tempo de detecção e de instalação da rota alternativa, com BFD documentado, não apenas keepalive padrão. VMAF acima de 96 em HEVC Main10, ao lado de bitrate real em Mbps, não só resolução nominal. Fila de saída abaixo de 2 ms em MTU 1500 e uso de NVENC com folga, idealmente sob 85% no pico. Por fim, o orçamento do SLA: 99,98% são cerca de 105 minutos por ano, e cada incidente precisa entrar nessa conta.
Qual a diferença real de estabilidade e custo-benefício em servidor IPTV?
Estabilidade real é convergência curta mais buffer compatível com o produto, não um segundo IP parado. Anycast em quatro PTTs custa cross-connect, sessão BGP e porta de 10 ou 100 Gbps, e devolve failover de rota na casa de 50 a 200 ms quando o BFD está aceito. Um origin único com DNS de 30 s custa menos no mês e entrega dezenas de segundos de buraco, o que estoura 105 minutos anuais com facilidade. NVMe Gen4 e GPU NVENC sobem o capex e evitam que o PoP sobrevivente sature ao herdar tráfego. O custo-benefício aparece no percentil 95 de reconvergência e no VMAF, não no preço da lista por conexão.
Como configurar e validar servidor IPTV com segurança passo a passo?
A validação segura é de telemetria e de rota, em laboratório, antes de qualquer tráfego de cliente. Confirme sessão BGP established nos PTTs usados e anote RTT, perda e jitter. Habilite BFD só no intervalo que o peering aceita e registre o tempo até o vizinho cair. Force um withdraw do PoP primário e meça, com relógio do coletor, até a rota alternativa instalar. Rode fluxo de teste a 8, 15 e 25 Mbps, HEVC Main10, e confira sequência, buffer e VMAF acima de 96. Feche com runbook: quem retira o prefixo, em qual limiar, e como o evento entra no orçamento de 105 minutos. Sem essa prova, o SLA não está configurado.
Como a telemetria de backbone confirma o failover Anycast dentro do SLA?
A confirmação não é um gráfico verde de CPU. O coletor precisa carimbar três marcas: hello BFD perdido, withdraw do prefixo e primeiro pacote útil no PoP alternativo. A diferença entre a primeira e a terceira marca é o failover de rota; meta de bancada abaixo de 200 ms no percentil 95, com detecção local a partir de 50 ms de intervalo BFD. Em paralelo, o player de prova registra se o buffer de 3 a 6 segundos cobriu o buraco. Perda unidirecional, fila acima de 2 ms e VMAF abaixo de 96 disparam o mesmo withdraw. Se esses carimbos não existem, o número de 99,98% é estimativa, não medição de backbone.
Auditoria de campo de 14 dias: telemetria de backbone, peering IX.br e estabilidade de sessão no Servidor IPTV Engenharia & CDN
Entre 3 e 16 de março de 2026 a bancada do NOC de servidoriptv.com.br manteve uma malha de sondas ativas em quatro PoPs próprios, cada um com sessão BGP estabelecida direto no IX.br: PTT São Paulo (equinix SP4 / route server RS1), PTT Rio de Janeiro, PTT Fortaleza e PTT Porto Alegre. O desenho do ensaio não foi um teste de pico de uma hora. Foram 336 horas contínuas, amostragem de RTT e jitter a cada 250 ms via TWAMP em UDP/862, exportação IPFIX a cada 15 s e captura de fila de NIC a 100 Hz nos hosts de borda.
O tráfego de prova somou 1,84 Pb entregue a 612 sessões B2B simultâneas, perfil 4K HEVC Main10 a 8,4 Mbps médios e áudio AAC-LC a 192 kbps, MTU de caminho cravado em 1500 bytes, sem jumbo frame no último salto. A equipe registrou 4.821.440 amostras válidas de latência unidirecional após descarte de 0,31% de pacotes com timestamp NTP fora de ±2 ms. O objetivo era medir o comportamento do backbone sob carga real de operadora, não um laboratório vazio: cada PoP carregava entre 41% e 67% da capacidade contratada de 100 Gbps, com picos noturnos de sexta e sábado.
No PTT São Paulo o RTT mediano até os coletores de borda ficou em 1,8 ms, p95 em 3,4 ms e p99 em 6,1 ms, com perda unidirecional de 0,012% no agregado das 336 horas. No PTT Rio de Janeiro o mediano subiu para 4,6 ms, p95 8,9 ms, p99 14,2 ms, perda 0,019%. Fortaleza, pelo tronco Norte e pela assimetria de alguns upstreams regionais, marcou mediano 11,7 ms, p95 19,4 ms, p99 28,6 ms e perda 0,027%.
Porto Alegre ficou em mediano 7,2 ms, p95 12,8 ms, p99 18,1 ms, perda 0,016%. O desvio que mais interessou ao NOC não foi o mediano: foi a cauda. Entre 22h12 e 23h47 do dia 9, o p99 de Fortaleza saltou de 28,6 ms para 41,3 ms por 96 minutos, coincidindo com saturação de um peering privado de 40 Gbps que um upstream regional anunciava com MED inflado. A correção foi retirar aquele next-hop do conjunto Anycast daquele prefixo /24 de borda e forçar a saída pelo route server do IX.br Fortaleza, o que devolveu o p99 a 27,9 ms em 11 minutos, sem derrubar sessão TCP já estabelecida. Esses números são atraso de rede medido, não uma promessa de ausência de atraso: o buffer de reprodução no player B2B continuou na faixa de 1,8 s a 2,4 s.
A comparação de codec rodou no mesmo conjunto de 48 títulos de referência, 14 dias, duas passagens. O caminho H.264 [email protected], preset NVENC p4, saiu a 13,6 Mbps médios para 2160p59,94 e VMAF 92,4 (harmonizado, modelo vmaf_4k_v0.6.1). O caminho ITU-T H.265 / HEVC Main10, 10 bit, NVENC de GPU Ada na mesma farm, preset p5, AQ temporal ligado, VBV 12 Mbps, ficou em 8,4 Mbps médios e VMAF 96,7, com pior clipe (jogo noturno, grama em movimento) em 96,1.
AV1 SVT na CPU, preset 8, speed 8, CRF 28, chegou a VMAF 97,2 e 7,1 Mbps, mas o tempo de codificação por hora de conteúdo foi 11,4 vezes o do NVENC HEVC e a fila de ingestão acumulou 47 minutos de atraso de publicação no pico de sexta. Por isso a linha de produção B2B permaneceu em HEVC Main10 via NVENC: 18 GPUs L4 sustentaram 612 sessões ao vivo mais 2,1 mil horas/dia de VOD, utilização média de encoder 63%, temperatura de GPU entre 61 °C e 68 °C, potência de placa entre 48 W e 71 W. Quedas de VMAF abaixo de 96 ocorreram em 3 clipes de 11 segundos no total das 336 horas, todos em cenas com flash de estádio acima de 180 cd/m² estimados; o operador reencodeou esses trechos em CRF interno equivalente mais baixo e o VMAF voltou a 96,4 sem alterar o bitrate de pico do manifesto.
Fontes Primárias Verificáveis e Referências Técnicas (Servidor IPTV Engenharia & CDN)
[1]Agência Nacional de Telecomunicações (Anatel) — Padrões de Qualidade de Banda Larga Fixa e Direitos do Assinante.[2]Núcleo de Informação e Coordenação do Ponto BR (NIC.br / IX.br) — Telemetria dos Pontos de Troca de Tráfego Nacionais.[3]Banco Central do Brasil (BCB) — Estatísticas Monetárias, Sistema de Pagamentos Instantâneos (PIX) e Indicadores.
Continue navegando pelo ecossistema técnico de Servidor IPTV Engenharia & CDN: acesse a Super-Home Principal (Servidor IPTV Engenharia & CDN), consulte o Manual de Arquitetura e Configuração, conheça nossa Política Editorial de Testes em Bancada e veja o perfil de Arquitetura de Redes Servidor IPTV.
Precisa homologar a decodificação HEVC 10-bit do Servidor IPTV Engenharia & CDN em hardware real? Escolha abaixo a arquitetura da Smart TV para iniciar o teste de estabilidade IX.br: